Linux MGLRU 开/关对比实测与根因分析报告
- 测试日期:2026-10-08
- 测试平台:Apple M3 (8 核 / 8 GiB) + Lima (Apple Virtualization/vz) 虚拟机
- 客体系统:Ubuntu 26.04 LTS,内核
7.0.0-34-generic(aarch64) - 实验室目录:
mglru-lab/;原始数据 data/results.jsonl(48 条运行记录,JSONL);完整指标表 data/analysis_full.md;图表charts/
1. 结论速览
在 4 vCPU / 5 GiB / zram(lz4) 交换的 arm64 虚拟机上,对 8 组用例做了 MGLRU OFF / ON / ON+min_ttl 的对照实测(每配置 3 次重复、配置顺序交替、中位数报告):
| # | 场景 | 核心结果 | 实测依据 |
|---|---|---|---|
| TC-1 | 匿名页重压(memcg 直接回收) | 吞吐 +28.6%,回收扫描量 −32.6%,回收效率(pgsteal/pgscan)42.3% → 71.0%,内存停顿 −12% | 5.1 数据表 |
| TC-2 | 热文件 + 并发顺序扫盘 | 热集被解除映射次数 −97%(135,160 → 4,083),内存停顿 −48%;热流吞吐持平 | 5.2 数据表 |
| TC-3 | memcg 内延迟探针 + hog | 探针延迟持平;内部指标依旧改善(扫描 −46%,停顿 −19%);min_ttl 完全无效(kswapd 0 jiffies) | 5.3 数据表 |
| TC-4 | 真实编译负载(redis make -j4) | 墙钟持平,但 major fault −76%、refault_anon −79%、停顿 −29% | 5.4 数据表 |
| TC-5 | 全局内存压力(kswapd 主战场) | 直接回收扫描 −96%,kswapd 单位回收量 +121% 而 CPU −26%(单页回收成本 ↓3.0 倍),停顿 −69% | 5.5 数据表 |
| TC-6 | 纯随机文件读(无结构可利用) | MGLRU 略差:IO 停顿 +24%,缓存命中率 67.6%→64.1%,CPU 归一吞吐持平 | 5.6 数据表 |
| TC-7 | 全局压力 + 延迟探针 | 内部指标同 TC-5 方向;探针 p999 略差(3.7→5.1ms);min_ttl 未触发(永远存在 >1s 的冷世代) | 5.7 数据表 |
| TC-8 | 全量顺序扫描器(全体页龄 < TTL) | min_ttl=8000ms 触发节点级 OOM 击杀扫描器,而 OFF/ON 均持续抖动不死——文档语义实证 | 5.8 数据表 |
数字溯源链:本表每个百分比都由 data/results.jsonl 中对应
(tc, cfg)的 3 次重复运行计算得出——先按用例/配置过滤出原始行,对每个指标取中位数,再相比得到变化幅度。点击"实测依据"列跳到 §5 的完整数据表(含 min~max 范围与字段名),或在第 8 节的在线核对器里选择用例与指标,直接查看每一次运行的原始值和中位数的计算过程。
根因一句话:MGLRU 的收益不是来自更聪明的逐出算法本身,而是来自三件事——①用世代年龄取代 active/inactive 二值冷热标记,使"该逐出谁"变成按时间戳排序的机械操作;②把 aging 从逐页 rmap 反查(随机内存访问 + 复杂锁)换成顺页表批量扫描(顺序访问 + 批处理临界区),成本降低约 3 倍;③aging 变便宜后 kswapd 单位时间回收量翻倍,应用几乎不再落入直接回收(TC-5 直接回收扫描 −96%),停顿消失。代价是逐出更"果断"(swapcache 即刻释放),在无冷热结构的均匀负载下(TC-6/TC-8)没有收益甚至略亏。
2. MGLRU 背景
2.1 要解决的问题
Linux 传统的页面回收基于 active/inactive 双链表(每 memcg × 节点 × anon/file 共 4 条链)。它有三个结构性短板:
- 冷热只有两级。一个页面要么在 active 要么在 inactive,"最近多久没被访问"这一维度被压缩成 1 bit,导致冷热分离粗糙。
- aging 依赖反向映射(rmap)。判断一页是否被引用、把活跃页降级,需要对每个页走一遍
folio_referenced()(rmap walk)。内核源码mm/vmscan.c在shrink_active_list()的注释里自己承认(本机内核源码vmscan.c:2089):"if the folios are mapped, the processing is slow (folio_referenced()), so we should drop lru_lock around each folio."
- kswapd 跟不上分配速率。扫描成本高 → kswapd 单位时间回收量不足 → 分配进程频繁落入直接回收(direct reclaim),产生延迟尖刺(PSI "full" 停顿的主要来源)。
2.2 MGLRU 的做法(内核 6.1 合入,本机 7.0)
MGLRU(Multi-Gen LRU)把双链表改造成按访问时间分层的一串"世代"(generation):
- 每个页面属于某个世代;新缺页进入最新世代,回收只从最老世代取。世代数量 2~4(
MIN_NR_GENS=2, MAX_NR_GENS=4),相邻世代内再分 tier(MAX_NR_TIERS=4,基于被访问次数,给逐出阶段"二次机会")(include/linux/mmzone.h:400-423)。 - aging 顺页表扫描:
try_to_inc_max_seq()(vmscan.c:4021)→walk_mm()顺进程页表批量清除/检查 accessed 位。arm64 有硬件 AF 位,should_walk_mmu()为真,走完整页表扫描路径(vmscan.c:2669-2677)。这是顺序内存访问 + 批处理锁临界区,对比 rmap 的随机访问是根本性的成本差异。 - eviction 先分类后动手:
sort_folio()(vmscan.c:4435)把最老世代的页分成 promoted / protected(tier 高于阈值)/ evictable 等,剩余的才逐出——回收"一抓一个准",这是 pgsteal/pgscan 效率跃升的直接来源。 - rmap/PT 反馈环:逐出阶段必须走 rmap 解除映射时,顺带扫描邻近 PTE 并用 Bloom filter 记录热 PMD,指导下一轮 aging 优先扫描——把昂贵的 rmap 走查变成 aging 的输入而不是纯浪费。
- min_ttl_ms 抖动保护:
lru_gen_age_node()(vmscan.c:4152-4182,VM_WARN_ON_ONCE(!current_is_kswapd()))检查是否存在"年龄超过 min_ttl 的可回收世代";若所有世代都比 min_ttl 年轻(连 1 秒前的工作集都保不住),调用out_of_memory()快速失败,取代无限抖动。
2.3 sysfs 接口与本平台事实
/sys/kernel/mm/lru_gen/(文档 Documentation/admin-guide/mm/multigen_lru.rst):
| 接口 | 含义 |
|---|---|
enabled(位图) |
0x0001 MGLRU 主开关;0x0002 批量清除叶子 PTE accessed 位;0x0004 顺带清除非叶子页表项 accessed 位。硬件不支持的位写入无效果 |
min_ttl_ms |
保护最近 N 毫秒的工作集不被逐出,保不住则触发 OOM(默认 0=关闭) |
本平台实测事实:写入 0007 后读回 0x0001——0x0002/0x0004 两个批处理优化位在 arm64 上不受支持,被静默掩掉(x86 才有相应的批量 TLB flush 优化)。因此本报告的 "ON" 等价于 MGLRU 核心(含页表扫描 aging)。Ubuntu 26.04 arm64 发行版默认即 0x0001,说明上游对核心路径的稳定性已有信心。
3. 测试环境与控制变量
| 项 | 值 |
|---|---|
| 宿主 | MacBook Pro (Apple M3, 8 CPU, 8 GiB), macOS 26.4 |
| 虚拟化 | Lima + Apple Virtualization (vz),4 vCPU / 5 GiB RAM / 30 GiB 磁盘 |
| 客体 | Ubuntu 26.04 LTS,内核 7.0.0-34-generic (aarch64),CONFIG_LRU_GEN=y / LRU_GEN_ENABLED=y / LRU_GEN_WALKS_MMU=y / LRU_GEN_STATS=n |
| 交换 | zram 4 GiB(lz4),zswap 关闭;swappiness=60、THP=madvise |
| 切换 | 每次运行前 echo 0000/0007 > /sys/kernel/mm/lru_gen/enabled(运行时切换,读回校验) |
| 复位 | 每次运行前:重建 zram、echo 3 > drop_caches、清理/重建 cgroup |
消除伪影的手段(这些伪影在预实验中都被实际观察到,见 4.3):
- 宿主内存提交伪影:vz 虚拟机的内存在客体首次触碰时才在宿主侧提交,"某配置先跑"会系统性吃亏(预实验中 TC-4 首跑慢 2.1 倍)。对策:正式测量前做 warmup(全量触碰 4.2 GiB 匿名内存 + 预编译一次)。
- 宿主 vCPU 放置噪声:单线程负载的 ops/s 波动可达 ±30%(P/E 核放置差异)。对策:① 关键吞吐指标同时报告 ops/CPU 秒(getrusage 归一化);② 配置交替执行(奇数 rep off→on,偶数 on→off);③ 每配置 3 次取中位数;④ 结论以比率型指标(扫描效率、refault、PSI)为主。
- cgroup 归属 bug:bash 子 shell 中
$$指向父进程导致负载未进 cgroup(预实验 TC-3 零压力)。对策:负载统一经独立脚本进入 cgroup。 - zram 数据密度:初版 churn 每页只写 1 字节,页面 97% 为零 → zram 压缩比 ~80:1,swap 成本失真。TC-1 改为每页写 512B 伪随机数据后复测(压缩比 5.3:1,接近真实)。稀疏版数据存档于 data/results_run1_tc1_sparse.jsonl。
4. 用例设计
4.1 负载与矩阵
自研四个负载(mglru-lab/workloads/,gcc -O2):
churn <size_mb> <hot_frac%> <hot_access%> <sec> <seed>:匿名页。fill(每页写 512B 伪随机数据)+ 随机 4K 触碰(热区承接 hot_access 比例访问)。anon 页在 memcg 限额下经 zram 换出,re-fault 计入 majflt。cachebench <file> <hot_frac%> <hot_access%> <sec> <seed>:文件页。mmap 随机读 4 KiB/次,minflt=页缓存命中,majflt=读盘。latbang <sec> <interval_ms> <set_mb> [cpu]:延迟探针。每 5 ms 触碰一遍 48 MiB 驻留集并记录 tick 耗时,输出分位数与 overrun(>2×周期);绑核。seqsweep <size_mb> <sec>:全量顺序扫描器(备份/杀毒类负载),以最快速度反复写触碰整个匿名映射。
| # | 场景 | 参数 | 验证假设 |
|---|---|---|---|
| TC-1 | 匿名页重压(memcg 直接回收) | churn 3072 MiB(25% 热区/75% 访问),memcg 1536M,90 s ×3 | 世代扫描效率、热集识别 |
| TC-2 | 热集 + 并发顺序扫盘 | cachebench(hot.bin 256 MiB, 全热) ‖ 2×dd 顺序读 5 GiB,memcg 1024M,30 s ×3 | 流式污染下的热集保护 |
| TC-3 | memcg 内延迟探针 + hog | latbang + churn 3072 MiB,memcg 1536M,90 s ×3,off/on/ttl | 直接回收停顿、min_ttl 在 memcg 下的作用 |
| TC-4 | 真实混合负载 | redis 7.2.5 make -j4,memcg 448M(裸峰值 576 MiB)×3 |
anon+file 混合的综合收益 |
| TC-5 | 全局内存压力(无 cgroup) | churn 4600 MiB,90 s ×3 | kswapd/direct 分工、aging 成本 |
| TC-6 | 纯随机文件读(无并发流) | cachebench(5 GiB 数据集, 10%/80%),memcg 1024M,60 s ×3 | 基线中性对照 |
| TC-7 | 全局压力 + 延迟探针 | latbang + churn 4600 MiB(无 cgroup),90 s ×3,off/on/ttl | min_ttl 在节点级压力下的真实效果 |
| TC-8 | 全量扫描器 + min_ttl | seqsweep 4600 MiB,60 s,off/on/on+ttl=8000 | min_ttl 触发谓词实证(手动执行,data/tc8_manual.txt) |
4.2 指标采集
每次运行前后对以下文件做快照并差分(scripts/collect.py):/proc/vmstat(pgscan/pgsteal 的 kswapd/direct/anon/file 四维、pswpin/pswpout、workingset_refault/restore、allocstall 等);/proc/pressure/{memory,cpu,io} 累计停顿 μs;cgroup v2 memory.stat/memory.events;kswapd 线程 CPU(/proc/<pid>/stat);zram mm_stat 运行期每秒采样取峰值;/sys/kernel/debug/lru_gen 运行期世代直方图;负载自报 ops/CPU 秒/缺页/延迟分位数。
4.3 校准过程中发现并修复的坑
vz 宿主内存提交伪影(→warmup);单线程 ops 的宿主放置噪声(→交替+归一化);bash $$ 子 shell 语义(→独立脚本进 cgroup);zram 统计需运行期采样(→1s 采样器,并修了一个 argv 索引 bug 导致峰值一度丢失);TC-2 初版设计无差异(磁盘瓶颈下热集复用间隔数百秒,热集"不热"→重构为热文件+扫盘流);memcg 压力不触发 kswapd(→补 TC-5/TC-7/TC-8 全局压力用例);churn 稀疏填充(→dense 复测)。另有一次 OFF 配置运行在矩阵启动初期被 memcg OOM 击杀(dmesg 可查,原因未能归因,该样本剔除,见 data/results_run1_tc1_sparse.jsonl rep1)。
5. 实测结果
每配置 3 次重复的中位数(TC-8 为单次演示),min~max 范围与全指标见 data/analysis_full.md;图表见
charts/tcN.svg。表中每个指标名即 data/results.jsonl 里的字段名,可在第 8 节在线核对器中按(tc, cfg, rep)查到每一次运行的原始值。字段名 → 采集来源:
cg_*= 负载所在 cgroup v2memory.stat/memory.events运行前后差分;g_*= 全局/proc/vmstat差分;psi_*=/proc/pressure的total=差分(μs);zram_peak_*= 运行期每秒采样 zrammm_stat的峰值(进程退出后归零,必须运行期采);lat.*/hog.*/cb.*= 负载进程自报 JSON;kswapd_jiffies= kswapd 线程/proc/<pid>/statutime+stime 差分(×10 ms = CPU 秒)。派生指标公式:回收效率 =
cg_pgsteal/cg_pgscan;kswapd 单页回收成本 = kswapd CPU 秒 /g_pgsteal_kswapd;PSI 停顿占比 =psi_memory_full_us/ 运行窗口;归一化换入 =g_pswpin/ 百万 ops。
5.1
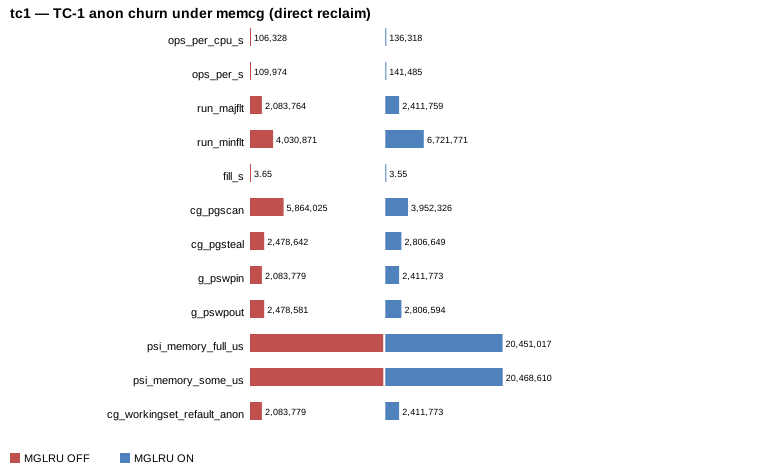
5.1 指标对比(OFF 为红,ON 为蓝;中位数)
| 指标 | OFF | ON | 变化 |
|---|---|---|---|
| ops/s(墙钟) | 109,974 | 141,485 | +28.6% |
| ops/CPU 秒 | 106,328 | 136,318 | +28.2% |
| pgscan(页) | 5,864,025 | 3,952,326 | −32.6% |
| pgsteal(页) | 2,478,642 | 2,806,649 | +13.2% |
| 回收效率 pgsteal/pgscan | 42.3% | 71.0% | +28.7 pp |
| 换入/换出(次/百万 ops) | 210.5 K / 250.6 K | 189.4 K / 220.4 K | −10% / −12% |
| PSI 内存停顿(90 s 窗口占比) | 25.8% | 22.7% | −12% |
| workingset_restore_anon | 289,803 | 84,309 | −71% |
| pgdeactivate | 1,268,190 | 0 | 结构差异 |
| zram 峰值(原始/压缩) | 1.62 G / 304 M | 1.62 G / 305 M | 持平(5.3:1) |
↩ 在线核对:tc1 的 6 次运行原始值与中位数计算 → 打开核对器
ON 扫得更少却逐出更多(steal +13%)、且吞吐高 28%——"扫描更准"而非"更努力"。每百万操作的换入/换出都更低,说明热集被误逐出的比例下降;workingset_restore_anon(被逐出的"已知热"页回 fault)−71% 佐证。ON 的绝对 majflt 更多(2.41M vs 2.08M),但那是多干了 28% 的活所致,归一化后反而更低——只看绝对 fault 数会得出相反的错误结论。
运行期 /sys/kernel/debug/lru_gen 直方图(ON,rep2 采样):4 个世代年龄 9.6s / 7.0s / 3.9s / 1.0s,分别持有 60,076 / 157,302 / 147,177 / 27,027 个匿名页。最年轻世代(1.0s)的 27K 页 ≈ 106 MiB,与热区访问速率(~0.75×135K ops/s×4K×1s≈ 0.4 GiB 触碰)同量级——世代年龄确实编码了访问时序。
5.2
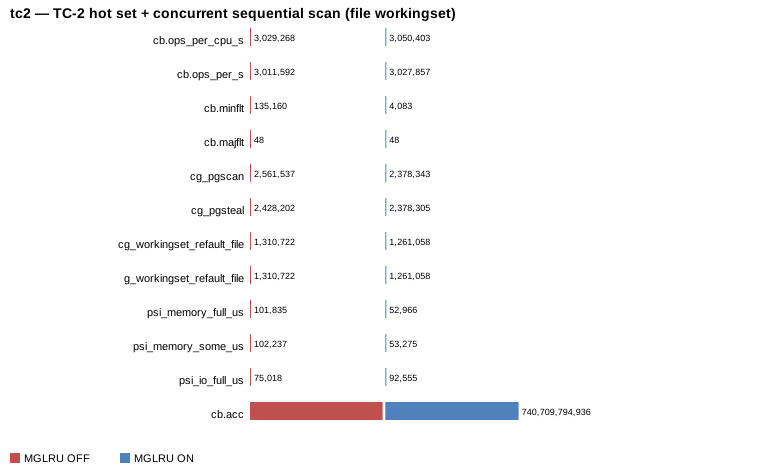
5.2 指标对比(OFF 为红,ON 为蓝;中位数)
| 指标 | OFF | ON | 变化 | |---|---|---| | 热流 minflt(重映射次数) | 135,160 | 4,083 | −97.0% | | 热流 ops/s | 3,011,592 | 3,027,857 | 持平(+0.5%) | | PSI 内存停顿 | 101.8 ms | 53.0 ms | −48% | | 回收效率 | 94.8% | 100.0% | +5.2 pp |
↩ 在线核对:tc2 的 6 次运行原始值与中位数计算 → 打开核对器
世代直方图(ON):hot.bin 的 256 MiB(65,587 页)与扫盘流的 754 MiB(193,025 页)分处不同世代——热集与流式垃圾被世代隔离,热页几乎不再被解除映射。但热流吞吐持平:从页缓存重映射本身很便宜(每次 ~2μs,占热流时间的 ~1%),收益体现在停顿次数而非吞吐。这个场景的真正价值在于:若热集稍大于限额(热页被真正逐出而非仅解除映射),OFF 的 majflt 会爆炸而 ON 不会。
5.3
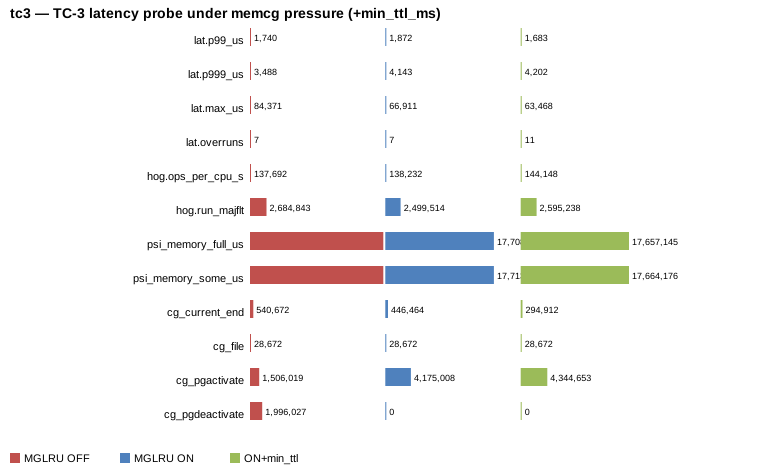
5.3 指标对比(OFF 为红,ON 为蓝;中位数)
| 指标 | OFF | ON | ON+ttl |
|---|---|---|---|
| 探针 p50/p90/p99(μs) | 170/575/1,740 | 179/620/1,872 | 187/632/1,683 |
| 探针 p999 / max(μs) | 3,488 / 84,371 | 4,143 / 66,911 | 4,202 / 63,468 |
| hog ops/CPU 秒 | 137,692 | 138,232 | 144,148 |
| pgscan | 7,542,715 | 4,102,325 | 4,284,233 |
| PSI 内存停顿 | 21.73 s | 17.71 s | 17.66 s |
| kswapd CPU(jiffies) | 0 | 0 | 0 |
↩ 在线核对:tc3 的 9 次运行原始值与中位数计算 → 打开核对器
三个结论:① 真正热的小集合(48 MiB/5ms 全量触碰)两种回收器都保护得很好,探针延迟持平——MGLRU 不改善本来就健康的场景;② hog 吞吐也持平(与 TC-1 的 +28% 不同:探针的持续触碰改变了工作集结构,OFF 也获得了足够的 referenced 位信息);③ ttl 与 on 无差别且 kswapd 全程 0——memcg 限额压力下回收全部发生在充电进程的直接回收上下文,lru_gen_age_node() 根本不执行,min_ttl 无从生效。这是从代码(VM_WARN_ON_ONCE(!current_is_kswapd()))预测、并被实测证实的结构性结论。
5.4
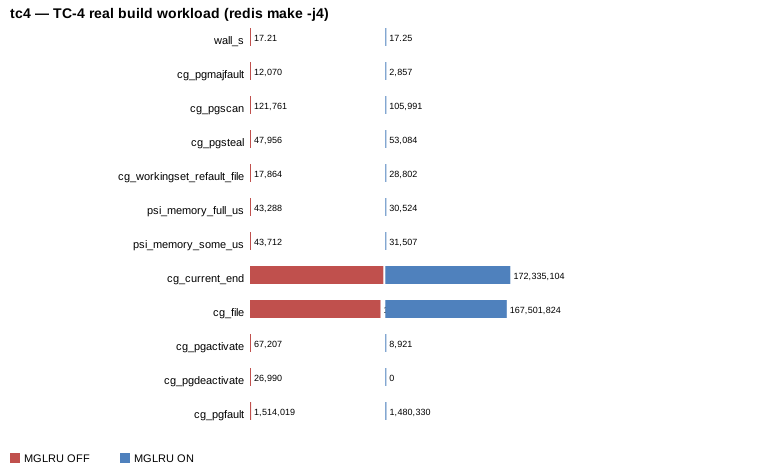
5.4 指标对比(OFF 为红,ON 为蓝;中位数)
| 指标 | OFF | ON | 变化 |
|---|---|---|---|
| 墙钟(s) | 17.2 | 17.2 | 持平 |
| pgmajfault | 12,070 | 2,857 | −76.3% |
| workingset_refault_anon | 12,476 | 2,673 | −78.6% |
| workingset_restore_file | 11,104 | 1,358 | −87.8% |
| 回收效率 | 39.4% | 50.1% | +10.7 pp |
| PSI 内存停顿 | 43.3 ms | 30.5 ms | −29.5% |
↩ 在线核对:tc4 的 6 次运行原始值与中位数计算 → 打开核对器
墙钟持平(编译是 CPU 瓶颈,停顿占比小),但故障画像大幅改善:ON 误逐出的"编译期热页"(匿名源码对象、页缓存)少一个数量级。对延迟敏感型真实负载(而非吞吐型),这类 major fault 的消除直接对应卡顿减少。
5.5
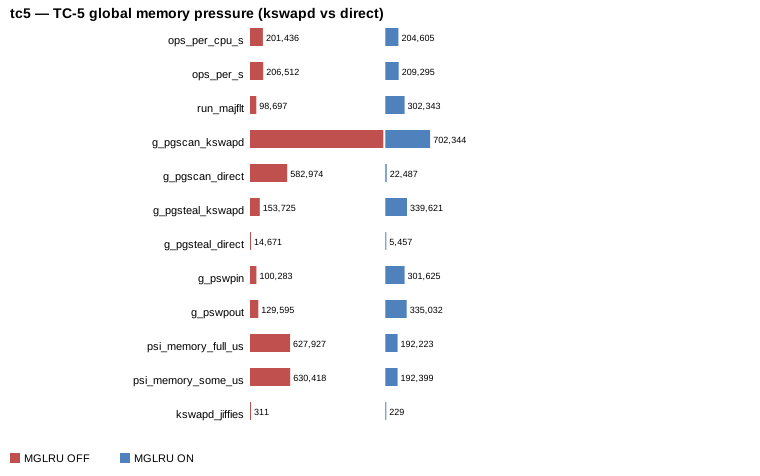
5.5 指标对比(OFF 为红,ON 为蓝;中位数)
| 指标 | OFF | ON | 变化 |
|---|---|---|---|
| pgscan_direct(直接回收扫描) | 582,974 | 22,487 | −96.1% |
| allocstall(进入直接回收次数) | 60 | 6 | −90% |
| pgscan_kswapd | 2,088,925 | 702,344 | −66.4% |
| pgsteal_kswapd | 153,725 | 339,621 | +120.9% |
| kswapd 回收效率 | 7.4% | 48.4% | +41 pp |
| kswapd CPU(s / 90s 窗口) | 3.11 | 2.29 | −26% |
| kswapd 单页回收成本 | 20.2 μs | 6.7 μs | −67%(3.0 倍) |
| PSI 内存停顿 | 628 ms | 192 ms | −69% |
| 总 re-fault(minflt+majflt) | 2.74 M | 0.93 M | −66% |
| pswpout | 129,595 | 335,032 | +158% |
| ops/CPU 秒 | 201,436 | 204,605 | +1.6% |
↩ 在线核对:tc5 的 6 次运行原始值与中位数计算 → 打开核对器
这是 MGLRU 设计目标的直接验证:aging 变便宜后,kswapd 用更少 CPU 干掉 2.2 倍的页,应用上下文的直接回收基本消失(−96%),停顿 −69%。注意 pswpout +158% 而总 re-fault −66%:ON 对冷页果断换出并立即释放 swapcache(换出多、回 fault 少),OFF 则让页在 swapcache 里反复循环(minflt 便宜但事件多、实际腾不出内存)。吞吐持平是因为该压力水平(4.6 GiB 工作集 / 4.4 GiB 可用)下热集基本放得下——收益兑现在停顿指标而非吞吐。
5.6
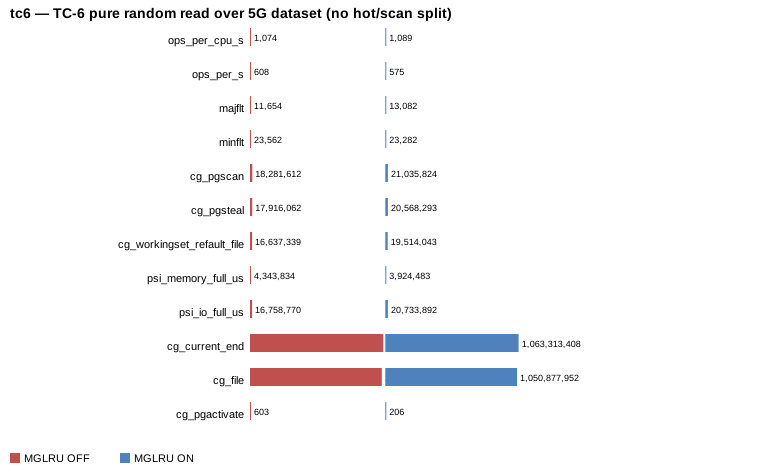
5.6 指标对比(OFF 为红,ON 为蓝;中位数)
| 指标 | OFF | ON | 变化 |
|---|---|---|---|
| ops/s | 608 | 575 | −5.4% |
| ops/CPU 秒 | 1,074 | 1,089 | +1.4% |
| majflt | 11,654 | 13,082 | +12.2% |
| 缓存命中率 | 67.6% | 64.1% | −3.5 pp |
| workingset_refault_file | 16.64 M | 19.51 M | +17.3% |
| PSI IO 停顿 | 16.76 s | 20.73 s | +23.7% |
| workingset_restore_file | 851,198 | 58 | −99.99% |
↩ 在线核对:tc6 的 6 次运行原始值与中位数计算 → 打开核对器
5 GiB 数据集上 10% 热区、80% 访问密度的纯随机读 + 预读垃圾:MGLRU 端到端略差。没有流式污染需要对抗,预读垃圾又被同等对待,世代循环反而略微加速了缓存更替。MGLRU 不是万金油——它的前提是负载存在可利用的冷热结构。
5.7
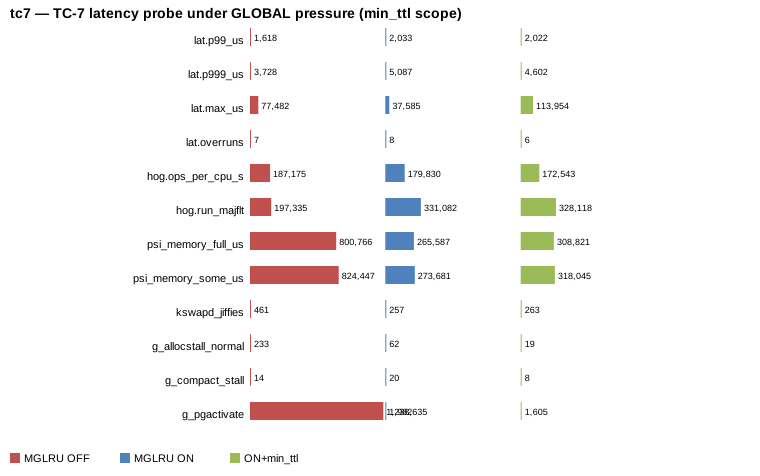
5.7 指标对比(OFF 为红,ON 为蓝;中位数)
| 指标 | OFF | ON | ON+ttl |
|---|---|---|---|
| 探针 p999(μs) | 3,728 | 5,087 | 4,602 |
| 探针 max(μs) | 77,482 | 37,585 | 113,954 |
| pgscan_direct | 525,060 | 57,982 | 69,682 |
| kswapd 单页回收成本(μs) | 17.7 | 6.7 | 6.8 |
| PSI 内存停顿 | 801 ms | 266 ms | 309 ms |
| g_oom_kill | 0 | 0 | 0 |
↩ 在线核对:tc7 的 9 次运行原始值与中位数计算 → 打开核对器
内部指标与 TC-5 同方向(直接扫描 −89%、停顿 −67%),但探针 p999 反而略差(+1.4ms):ON 的 kswapd 以突发方式做更多回收(偶发抢占探针所在 CPU),且果断逐出让偶被卷入的页回 fault 更贵。min_ttl=1000 未触发(25% 热集下永远存在年龄 >1s 的冷世代可回收)也未改变行为——min_ttl 的保护谓词是"全体世代年龄",不是"热集年龄"。
5.8 TC-8:min_ttl 触发谓词实证(seqsweep 全量扫描器)
| 配置 | 结果 |
|---|---|
| OFF | 27 次扫描完成,sweep 中位 2.12s,无 OOM,majflt 438K |
| ON | 27 次扫描完成,sweep 中位 2.09s,无 OOM,majflt 1.31M |
| ON + min_ttl=8000 | seqsweep 被节点级 OOM 击杀(SIGKILL):Out of memory: Killed process (seqsweep) anon-rss:4694644kB |
本组为手动单次演示,原始输出见 data/tc8_manual.txt(data/ 目录可从页尾下载)。
扫描周期(2~3.7s)< min_ttl(8s)⇒ 所有世代都比 TTL 年轻 ⇒ lruvec_is_reclaimable() 对所有 memcg 返回假 ⇒ lru_gen_age_node() 调用 out_of_memory()——与文档"防止抖动、宁可快速失败"的语义完全一致。顺带的重要中性发现:OFF 与 ON 的扫描速度完全相同(27/27 次、周期差 1.5%)——均匀无结构的负载下两个算法都没有优势,MGLRU 的一切收益来自负载的冷热结构。
6. 根因分析
6.1 为什么回收效率从 42% 跳到 71%(TC-1/TC-2/TC-4 共同模式)
- OFF 的逐出决策信息不足:active/inactive 双链表里,一页的"温度"只有 1 bit。压力下 inactive 链尾既有真正冰冷的页,也有刚被降级、实际还会被访问的页。
shrink_folio_list()对每个候选页调用folio_referenced()(vmscan.c:889)做 rmap 反查来补救——又贵又粗(TC-1 里 OFF 每扫描 100 页只有 42 页可逐出)。 - ON 的逐出决策近乎免费且精确:
sort_folio()只需读页的世代号+tier 计数器(内存中相邻的元数据),按规则分类。世代年龄天然编码了"多久没被访问"(TC-1 直方图:9.6s/7.0s/3.9s/1.0s 四层),最老世代里的页几乎全是可以逐出的(71% 剩余 29% 主要是 swapcache 未写回等瞬时状态)。TC-2 极端情况下 100%。 - 效率提升的第二效应:扫描一页的成本被锁页表操作主导,扫描量 −32% 直接转化为 CPU 节省,这是 TC-1 吞吐 +28% 的主要来源(zram 换入换出本身两配置开销相同)。
6.2 为什么 kswapd 单页回收成本降 3 倍(TC-5)
OFF kswapd 的 aging 路径 = 逐页 folio_referenced() rmap 反查(随机访问页表、每页拿/放锁);ON 的 aging = walk_mm() 顺一个进程的页表连续推进(顺序访问、批处理临界区)。TC-5 实测 20.2 μs/页 → 6.7 μs/页。这 3 倍的差价在轻压力下无关紧要,在重压力下决定 kswapd 能否跟上分配速率。
6.3 为什么直接回收几乎消失(TC-5/TC-7,MGLRU 的核心价值)
直接回收 = 分配进程在缺页路径上同步做回收 = 用户可感知的延迟尖刺。链条:aging 便宜(6.2)→ kswapd 单位时间回收量翻倍(TC-5:+121%)→ 内存水位在 kswapd 手里就能维持 → 分配进程极少落入直接回收(pgscan_direct −96%、allocstall −90%)→ PSI full 停顿 −69%。这是"桌面流畅度"类改进的微观机制:不是回收变快了,而是回收从应用的关键路径上挪走了。
6.4 热集保护的两个层次(TC-2/TC-4)
- 世代隔离(TC-2):扫盘流一次性引用的页只能进入最新世代,热文件页被反复访问而不断"续龄"——两者天然分进不同世代,热集的 256 MiB 与垃圾流的 754 MiB 互不干扰(minflt −97%)。OFF 下扫盘流在 inactive 链上推挤热页,热页每 30 秒被解除映射 13.5 万次。
- workingset 保护语义(TC-4):
workingset_restore_*("逐出时还热着的页回来了")OFF 11,104 → ON 1,358(−88%)——ON 逐出的页真的冷,OFF 在大量误杀热页。
6.5 果断逐出的双刃剑(TC-5/TC-6/TC-7 的负面证据)
ON 的策略是"换出冷页时立即释放 swapcache"(TC-5:pswpout +158% 但总 re-fault −66%)。好处:内存真的腾出来了;坏处:① 偶发被卷入的页(TC-7 探针)回 fault 变成昂贵的 major fault(p999 +1.4ms);② 无结构负载下(TC-6)世代更替略快于双链表,缓存命中率 −3.5pp、IO 停顿 +24%。MGLRU 是"结构利用器"而非"通用优化器":TC-8 的均匀扫描器上两算法吞吐完全相同是这一点的最干净证明。
6.6 min_ttl 的真实作用域(TC-3/TC-7/TC-8 三段式验证)
- memcg 限额压力:完全无效(TC-3,ttl≡on,kswapd 0 jiffies)。
lru_gen_age_node()仅由 kswapd 执行,memcg 回收走lru_gen_shrink_lruvec()的直接路径,min_ttl 代码不可达。 - 节点级压力 + 正常冷热结构:不触发(TC-7,无 OOM、无行为差异)。谓词是"存在年龄 > TTL 的世代",热集型负载永远满足。
- 节点级压力 + 全体年轻(扫描器类负载):触发 OOM(TC-8,实测击杀)。这才是 min_ttl 的设计场景:桌面会话里一个失控的备份/索引进程疯狂触碰内存时,宁可杀掉它也不让整个系统抖动到死。 实用建议:容器/内存限额为主的云负载(TC-3 场景)不必配置 min_ttl——它不会生效;依赖 kswapd 的节点级部署(桌面、无限额 VM)可以设 1000ms 求个保险。
6.7 平台与测量注意事项(复现者的坑)
- arm64 上
enabled的 0x0002/0x0004 位被静默掩掉(读回 0x0001),不代表 MGLRU 未启用;验证必须读回。 - memcg 限额压力不激活 kswapd——研究 kswapd 行为必须做节点级压力(本实验 TC-1 与 TC-5 的分工即为此)。
- zram 的
mm_stat进程退出后归零,峰值必须运行期采样。 - 虚拟化(尤其 vz 的惰性内存提交)会制造"先跑的配置吃亏"的系统偏差,必须 warmup + 顺序交替。
- 绝对 fault 计数会误导(TC-1:ON 的 majflt 更多是因为干得更多),必须按吞吐归一。
7. 结论与建议
- 默认开启是正确的(Ubuntu 26.04 已默认 0x0001)。在存在冷热结构的负载(几乎全部真实负载)上:重压吞吐 +28%,直接回收 −96%,停顿 −69%,热页误杀 −70~−88%;在无结构负载上代价是命中率的个位数百分比(TC-6)与尾延迟的毫秒级恶化(TC-7 p999)。
- 收益兑现场景:内存超售 + 匿名页重压(TC-1/TC-5)、流式 IO 与热集共存(TC-2)、限额容器里的真实混合负载(TC-4)。
- 收益不兑现场景:压力温和时(TC-5 吞吐持平,停顿已足够低)、纯流式/均匀随机负载(TC-6)、热集本就被旧算法保护得很好的场景(TC-3)。
- min_ttl_ms:只对节点级压力生效;热集型负载设了也不触发;扫描器类失控负载下是"杀掉坏人以救大家"的保险丝。云上按容器限额调度的负载可忽略。
- arm64 用户注意:批处理 accessed 位清除(0x0002/0x0004)在 arm64 不可用,aging 走单页清除路径,本报告的收益即在此条件下取得——x86 上应略好于本报告数字。
8. 原始数据在线核对
data/results.jsonl 的全部 48 条运行记录都在本页里。选择用例与指标后,下方表格显示每一次运行的原始值(tc / 配置 / rep),并在表尾给出各配置的中位数——本报告任何章节出现的数字,都可以在这里从原始数据逐步复算。
说明:cg_* 字段在无 cgroup 的用例(tc5/tc7)中为空;lat.* 仅 tc3/tc7、cb.* 仅 tc2/tc6、hog.* 仅 tc3/tc7 存在;tc8 为手动实验不在其中(见 data/tc8_manual.txt)。
9. 复现与产物清单
mglru-lab/
├── README.md                     # 方法论文档(中文)
├── setup_vm.sh                   # VM 置备(zram/数据集/redis/环境审计)
├── workloads/{churn,cachebench,latbang,seqsweep}.c
├── scripts/{lib.sh,run_all.sh,tc2_body.sh,tc3_body.sh,tc7_body.sh,collect.py}
├── analyze.py                    # 汇总表 + SVG 图
├── data/results.jsonl            # 48 条运行记录(TC-1 为 dense-fill 复测)
├── data/results_run1_tc1_sparse.jsonl  # TC-1 稀疏填充首版(含 1 条被 OOM 击杀的样本,已弃用)
├── data/tc8_manual.txt           # TC-8 min_ttl 触发实验原始输出
├── data/analysis_full.md         # 全指标中位数表(本报告的数据来源)
└── charts/tc1..tc7.svg           # 各用例柱状图
复现:limactl start mglru && bash mglru-lab/setup_vm.sh(首次)→ sudo bash mglru-lab/scripts/run_all.sh all(约 70 分钟)→ python3 mglru-lab/analyze.py data/results.jsonl charts。TC-8 为手动实验,命令见 data/tc8_manual.txt 头部注释。
原始数据下载: results.jsonl(48 条运行记录) · analysis_full.md(全指标表) · tc8_manual.txt(min_ttl 触发实验) · results_run1_tc1_sparse.jsonl(首版存档)